 VoicePaste
识别模型
选择在线或本地识别
- 在线模型:需要网络和自己的 API 凭证,音频会发送给所选服务。
- 本地模型:先下载模型文件,之后在设备上识别;无需申请 API Key,但会使用本机内存和处理器资源。
支持语言、热词和流式能力见 模型兼容清单。
配置在线模型
- 打开「设置 → 音频模型 → 在线模型」,选择提供商。
- 按对应教程申请凭证:火山引擎(豆包语音)、ElevenLabs。
- 将凭证填入对应模型卡片并保存,再启用该模型。
- 用快捷键录制一句话,确认收到识别结果。
在线服务的费用、额度与数据处理规则以提供商为准。先使用默认参数,确认识别正常后再调整。
下载并启用本地模型
- 打开「设置 → 音频模型 → 本地模型」。
- 根据语言和设备资源选择模型,点击下载;所需的语音活动检测(VAD)及标点组件会按模型配置一起准备。
- 等待下载完成,再启用模型。
- 完成一次语音输入,确认模型可用。
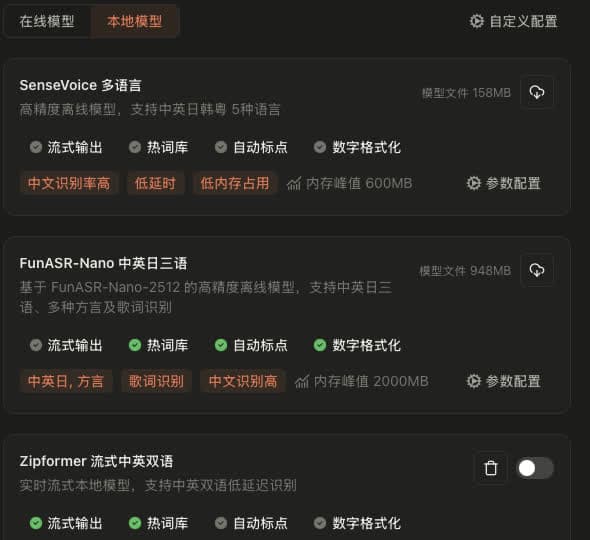
调整参数
在模型的参数配置中按需调整;不确定用途时保留默认值。需要自定义本地推理参数时再使用「自定义配置」。
常见问题
本地模型下载失败怎么办?
检查网络和可用磁盘空间后重试。
在线识别失败怎么办?
先检查凭证是否保存、服务是否开通及账户额度,再检查网络。提供商的专项排查见 火山引擎 和 ElevenLabs。
为什么不同模型的实时文字显示方式不同?
部分模型原生支持流式输出,其他模型使用应用的模拟预览,详见 模型兼容清单。